02 / AI 应用 / 2026
AI 询盘
与知识工作台
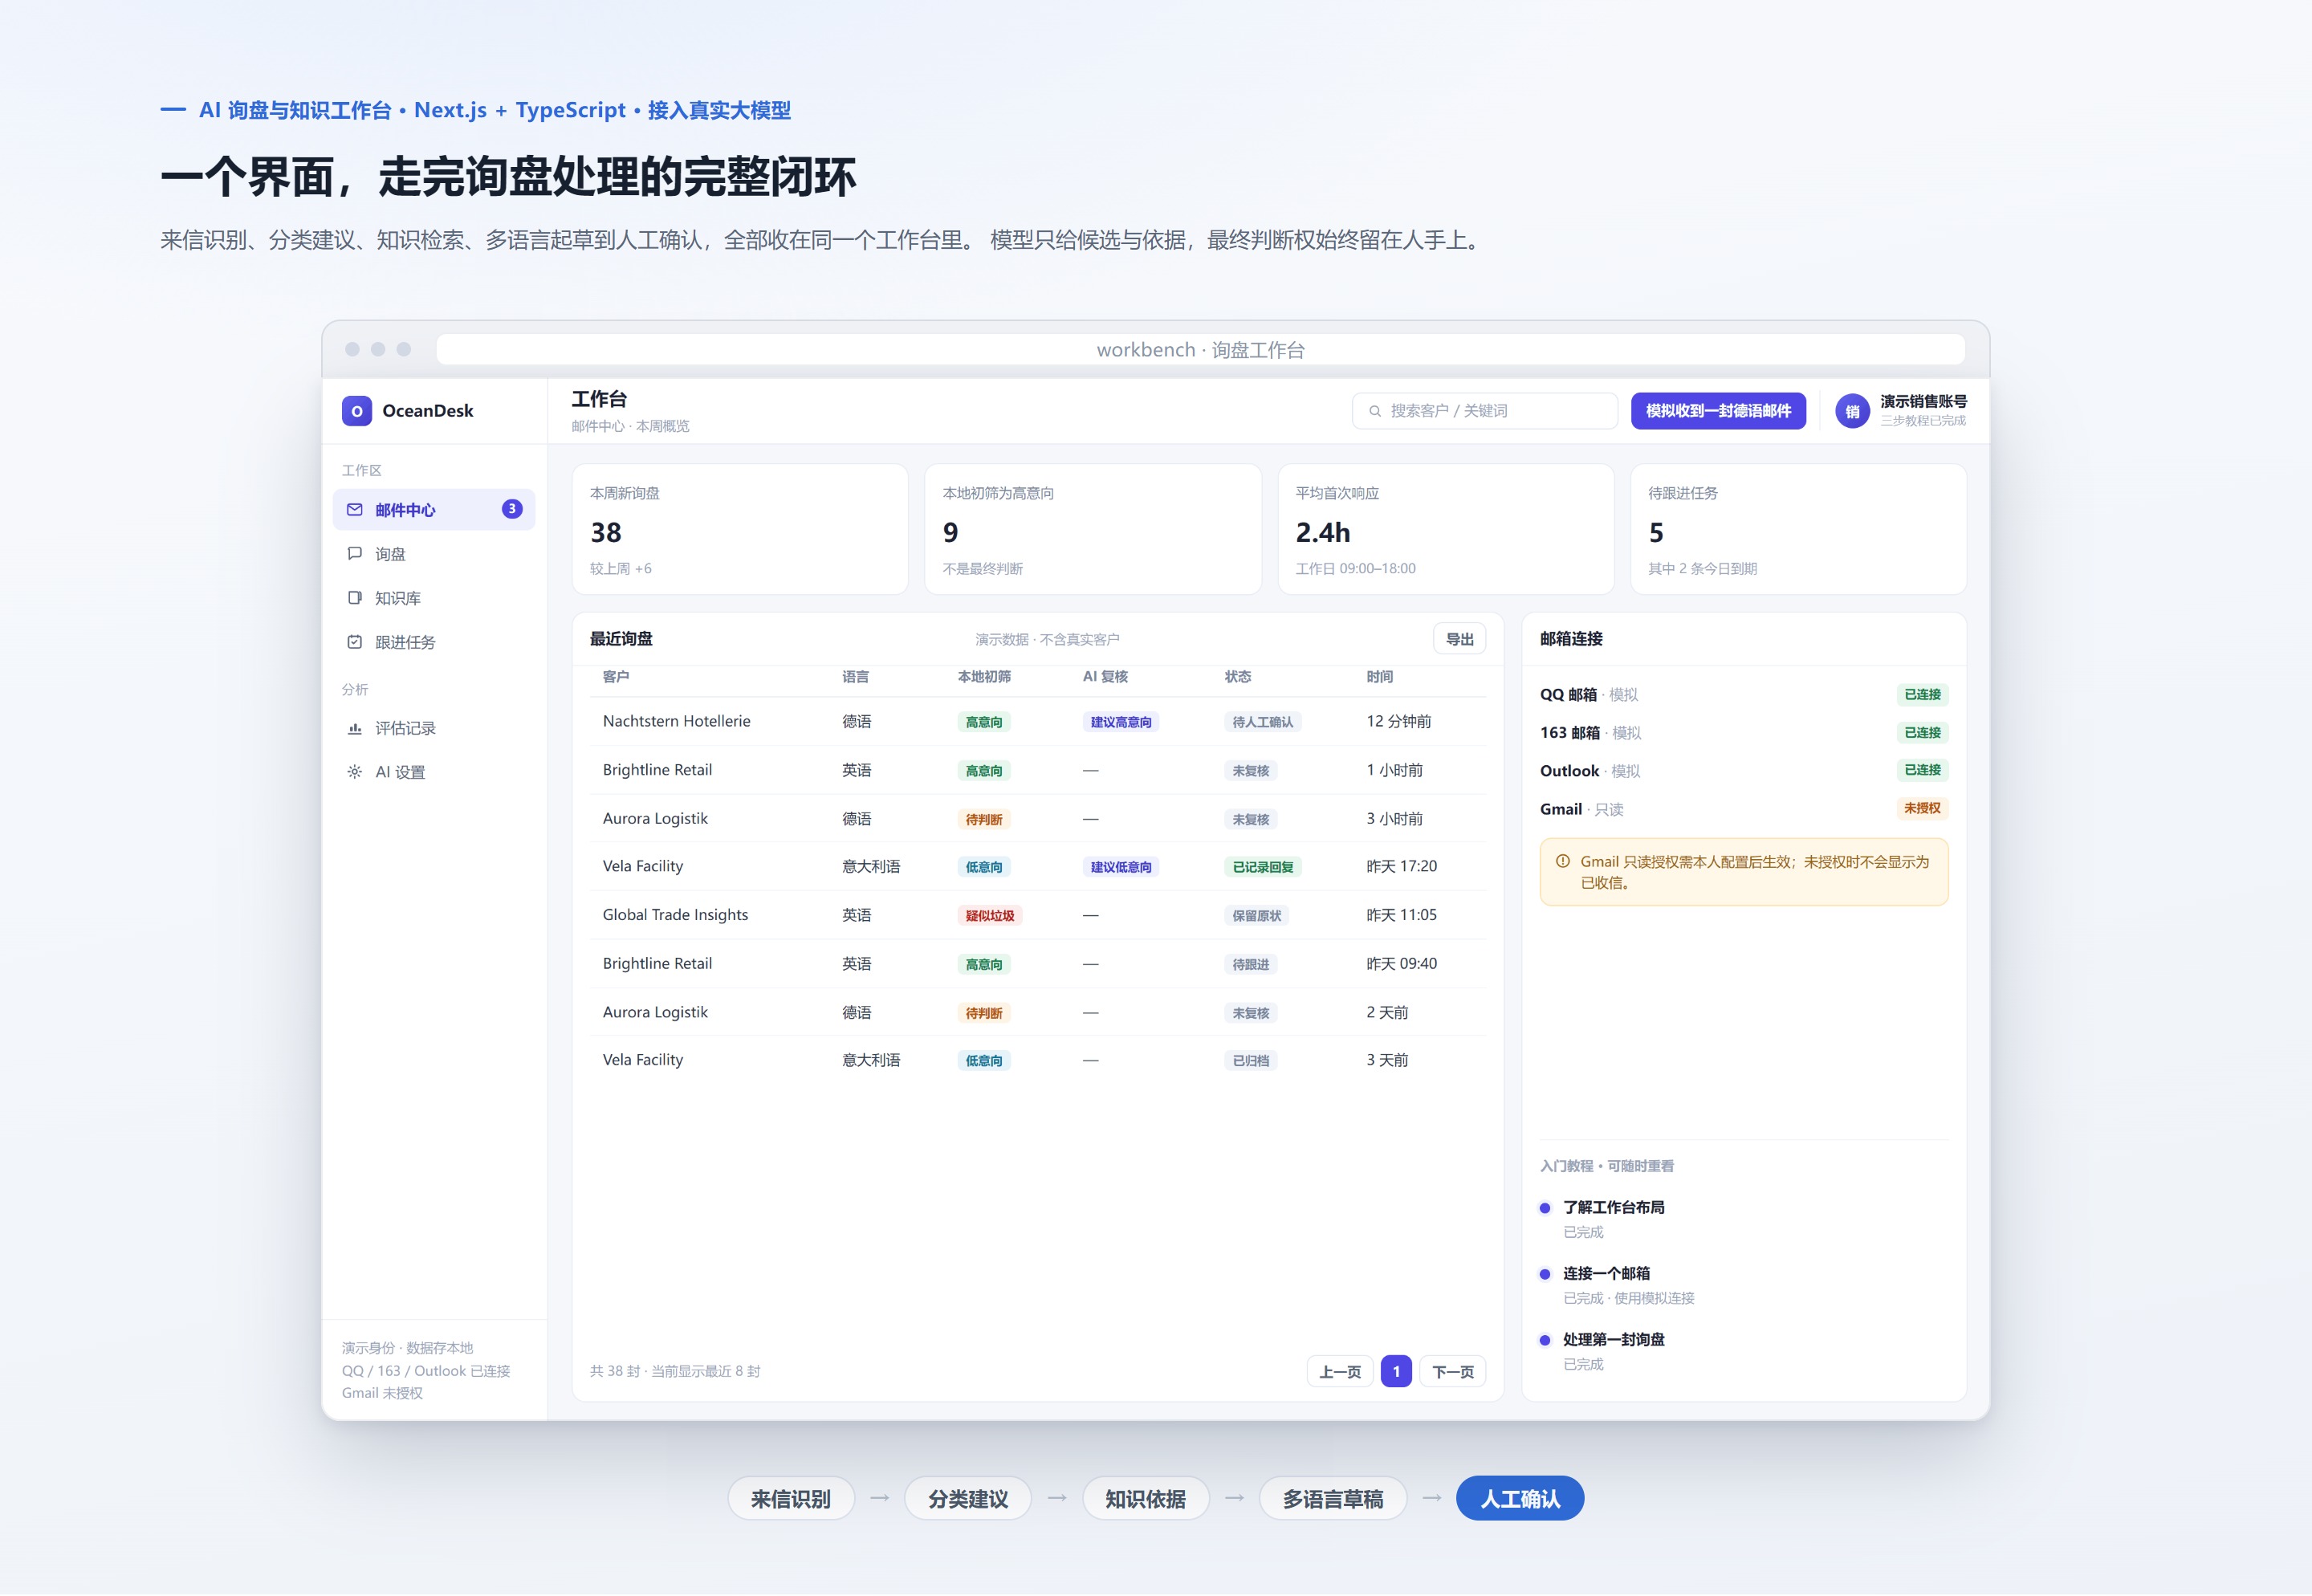
识别、判断、检索、起草 —— 询盘处理的前四步收进同一个界面, 每条结论都能点回原文依据;对外发送那一步,始终留在人手里。
Scroll to read
01 / The Problem
询盘进来的第一小时,
决定了回复质量。
判断意向、翻资料、写回复,每一步都压在同一个人身上。 资料散在聊天记录和本地文件里,新同事接不上手。
- 01语言与格式都不统一,同一封询盘要读两遍才敢回
- 02关键信息不完整,靠来回追问补齐,一封信要来回几轮
- 03产品参数与箱规靠人翻资料,翻错一次就报错一次价
- 04报价与交期一旦发出去就定了,改一次要重新谈一轮,客户未必等
02 / Product Goal
让 AI 打下手,
判断权留给人。
模型只给选项与依据,不给决定。人看到的每一条结论,都能点开看它凭什么这么判断。
对智力不敏感、对延迟和成本敏感的活,先用免费规则挡掉。
只处理人真正要看的那几封,不为了「用上 AI」而全量调用。
分类建议与草稿带引用,能点回原文与产品资料。
人工纠正后留记录 —— 纠正本身就是下一轮评测的样本。
03 / System Flow
一封询盘,
走完六个动作。
识别、分级、检索、起草由系统完成;确认由人完成。


04 / Retrieval
(设计稿)
答案的出处,
比答案本身重要。
这一屏是检索链路的设计稿,不是已经上线的功能 —— 当前版本只做到引用标注。 绝大多数「AI 答错了」,其实是「没找到对的资料」: 力气要花在检索侧,而不是反复调提示词。
- 切分按语义边界切,不按固定字数 —— 把一条规格从中间切开,模型永远拼不回来
- 召回关键词与向量混合:型号、料号这类精确词,纯语义召回最容易漏
- 重排「召回 20 条」和「把最相关的 3 条排到最前」不是同一件事
- 生成必须带引用;没有依据的句子不写具体数字


05 / Model & Evaluation
不选最强,
选最合适。
头部几家的综合分差距已经收窄到个位数,单价却能差出十倍以上。 真正的变量是三个:这个任务值多少钱、能不能等、错了谁的损失最大。
- 初筛规则优先,模型按需触发 —— 对智力不敏感,对延迟和成本极敏感
- 抽取大上下文 + 中等价位 —— 决定成败的是能不能把整份资料塞进去
- 写作写作质量第一梯队,价格次之 —— 措辞失礼的成本远高于 token 成本
- 长链路顶部模型,贵也值 —— 一步错会污染后面所有步骤,重跑代价更大
- 批处理能排队的一律走批处理接口,错峰跑、按折扣档结算 —— 不该按实时价付费

06 / Human In The Loop
不可逆的动作,
不交给系统。
这条链路砍掉了自动发送 —— 不是模型做不到,是价格和交期发出去以后收不回来。 把 AI 放在高频、低代价、可回滚的环节,把不可逆的动作留给人。
- 不外发只生成站内草稿与记录,发送动作由人完成
- 不改价报价数字来自资料库,模型只负责组织语言
- 不承诺交期与账期不作为 AI 的输出项
- 可推翻人工纠正分类后留痕,进入下一轮评测样本


07 / What Changed
省下来的,
是每天的第一个小时。
这套东西没有把人换掉,它把最费时的两步 —— 判断意向、翻资料 —— 挪到了人动手之前。下面这几个数,是上线前后拿同一批询盘对比出来的。
- 快在哪从「先翻资料再动笔」变成「在草稿上直接改」,省掉的是翻资料那一趟
- 判断有依据每条结论都能点回原文,新人不用挨个问同事也能分辨该不该接
- 错了不白错人工纠正留痕,纠正本身就是下一轮评测的样本,同类错误不重复出现
- 不会发错价报价与交期不出 AI 的手 —— 提速的前提是这条线没有被松开
关于数据:所有截图与示例均为合成数据或已脱敏处理,不含真实客户、供应商与账目信息。